Lect05 Mc-Culloch - Pitts Model and Learning Rules- Part-1
Lect05 Mc-Culloch - Pitts Modèle et Règles d'apprentissage- Partie-1
Mots-clés
Résumé
233 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative de cette séance réside dans la clarté de la progression pédagogique : l’enseignant part du modèle statique de McCulloch-Pitts, puis introduit la nécessité d’apprendre les poids, avant de présenter deux règles historiques fondamentales. L’argumentation est structurée et logique : chaque règle est introduite par son contexte historique, sa formulation mathématique, puis illustrée par un exemple numérique déroulé intégralement. La distinction entre apprentissage supervisé et non supervisé est posée de manière opérationnelle, en identifiant le « signal enseignant » comme critère discriminant. L’exemple de la règle de Hebb est particulièrement bien construit : il montre concrètement comment un poids initial arbitraire est raffiné échantillon par échantillon, et comment une itération complète correspond au passage sur l’ensemble des données. L’enseignant insiste sur la notion d’itération et sur le rôle d’une fonction de coût pour décider de l’arrêt de l’entraînement. La transition vers la règle du perceptron est argumentée par la limite de la règle de Hebb : l’absence de signal désiré. L’exemple du perceptron, bien qu’inachevé, illustre la correction d’erreur lorsque la sortie obtenue diffère de la sortie désirée. La faiblesse principale est l’absence de discussion sur les limites théoriques de ces règles (non-convergence de Hebb, théorème de convergence du perceptron non mentionné).
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique du contenu est globalement bonne : les formulations mathématiques sont exactes et les algorithmes présentés correspondent aux définitions canoniques. Les attributions historiques sont correctes dans leur substance (Hebb 1949, Rosenblatt 1958), même si la datation du modèle de McCulloch-Pitts est approximative (« 46 ou 47 » au lieu de 1943). Aucune source bibliographique n’est citée ni dans la description ni dans le discours ; l’enseignant s’appuie sur la connaissance établie du domaine sans référencer d’articles ou d’ouvrages précis. L’adéquation titre/contenu est satisfaisante : le titre annonce le modèle MCP et les règles d’apprentissage, et le contenu traite bien de ces deux aspects, la règle du perceptron étant introduite en fin de séance. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
346 mots
Adéquation titre / contenu
Le titre annonce le modèle de McCulloch-Pitts et les règles d'apprentissage ; le contenu traite effectivement du modèle MCP, de la règle de Hebb et de la règle du perceptron. Adéquation satisfaisante.
Qualité & fiabilité
7/10
Cours magistral classique sur les fondements historiques des réseaux de neurones. Les contenus présentés (modèle de McCulloch-Pitts, règle de Hebb, règle du perceptron) sont exacts et conformes à la littérature de référence. Les dates citées (1943 pour McCulloch-Pitts, 1949 pour Hebb, 1958 pour Rosenblatt) sont globalement correctes, même si l'enseignant évoque « 46 ou 47 » pour le modèle de McCulloch-Pitts, ce qui est une approximation. Aucune source bibliographique n'est citée explicitement. La démonstration numérique est cohérente et reproductible.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Rappel du modèle général d'un neurone formel : entrée x, poids w, net = w^T x, fonction d'activation.
- Présentation de la fonction de seuil du modèle McCulloch-Pitts : sortie 1 si net ≥ 0, sinon 0.
- Introduction de la notion de règle d'apprentissage : déterminer automatiquement le vecteur de poids w.
- Taxonomie des règles d'apprentissage : supervisé/non supervisé, compétitif, par renforcement, en ligne/par lots.
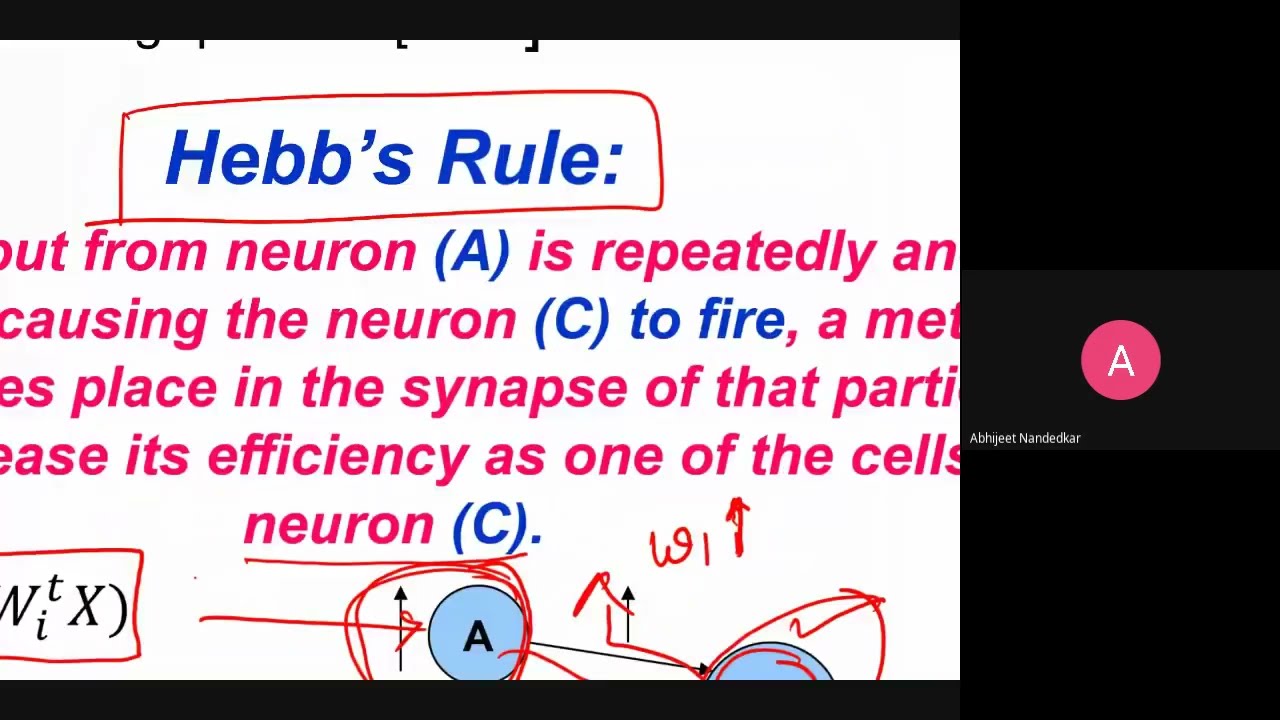
- Présentation de la règle de Hebb (1949) : inspiration biologique et principe de renforcement synaptique.
- Formulation mathématique de la règle de Hebb : Δw = c·o·x.
- Début de l'exemple numérique : trois échantillons, poids initial (1, −1, 0,5), fonction d'activation signe.
- Calcul de net1 = 3 et de la sortie o1 = +1 pour le premier échantillon.
- Mise à jour des poids : w2 = w1 + Δw, puis passage à l'échantillon suivant.
- Discussion de la notion d'itération et de la répétition de l'entraînement sur les mêmes échantillons.
- Transition vers la règle du perceptron (1958) : Δw = c·(d − o)·x, apprentissage supervisé.
- Exemple numérique du perceptron : classes cibles +1/−1, calcul de l'erreur d − o.
- Mise à jour des poids avec la règle du perceptron et invitation à terminer les calculs.
Apport & nouveautés
Cette séance n’apporte pas de contenu original au sens de la recherche : il s’agit d’un cours magistral de niveau introductif qui présente des résultats classiques et bien établis. Son apport réside dans la qualité de la progression pédagogique et dans le déroulé pas à pas des calculs, qui rendent opérationnels des concepts souvent présentés de manière abstraite. L’enseignant relie explicitement les règles d’apprentissage à leur contexte historique et à leur motivation biologique ou algorithmique, ce qui aide à comprendre pourquoi ces formulations ont été proposées. La comparaison directe entre la règle de Hebb et celle du perceptron, formulée comme un simple ajout du terme (d − o), met en évidence le rôle central du signal enseignant dans l’apprentissage supervisé.
Pour aller plus loin :
- Modèle de McCulloch-Pitts — Article présentant le neurone formel et le modèle historique de McCulloch et Pitts (1943).
- Règle de Hebb — Présentation de la règle d’apprentissage non supervisée proposée par Donald Hebb en 1949.
- Perceptron — Article sur le perceptron de Rosenblatt (1958), sa règle d’apprentissage et son théorème de convergence.
- Apprentissage supervisé — Cadre général de l’apprentissage supervisé, utile pour situer la règle du perceptron.
- Frank Rosenblatt, « The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain », Psychological Review, 1958 — Article fondateur de la règle du perceptron.
220 mots
Profil radar
Le profil radar indique un contenu à forte densité informative et à bonne qualité pédagogique, avec un niveau technique modéré correspondant à une introduction aux réseaux de neurones. La fiabilité est solide sur le plan mathématique, mais limitée par l'absence de références bibliographiques explicites et par une datation historique approximative.