02 ML Diffrent tools and application of ML
02 ML Différents outils et application de ML
Mots-clés
Résumé
229 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
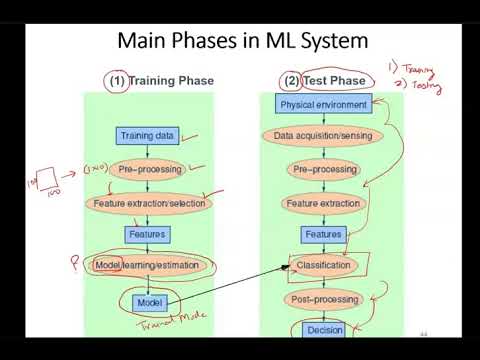
La valeur informative de cette vidéo réside dans sa clarté pédagogique sur les fondements conceptuels du machine learning. L’enseignant construit une progression logique : d’abord la structure générale d’un système d’apprentissage (données brutes → prétraitement → extraction de features → choix du modèle → entraînement → test), puis la taxonomie des approches historiques, et enfin une mise en œuvre concrète du théorème de Bayes sur un exemple jouet entièrement calculé. L’exemple numérique est particulièrement utile : il montre pas à pas comment calculer likelihood, prior et evidence, et comment la comparaison des posteriors conduit à la décision de classification. L’argumentation est cohérente et sans contradiction interne ; les formules sont correctes et la dérivation depuis la probabilité jointe est valide. En revanche, la profondeur reste limitée : aucune discussion des limites de l’approche bayésienne naïve (hypothèse d’indépendance conditionnelle, malédiction de la dimensionnalité), aucune mention des questions de généralisation, de surapprentissage ou de validation croisée, et le traitement des réseaux de neurones se réduit à une esquisse historique et anatomique. L’argumentation repose essentiellement sur l’autorité de l’enseignant et sur des exemples simplifiés, sans confrontation à des résultats expérimentaux ni à des controverses méthodologiques. Le propos sur l’histoire des réseaux de neurones (rôle attribué à Minsky dans l’arrêt de la recherche) est une simplification courante mais discutable, qui omet les contributions parallèles et les facteurs institutionnels.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est correcte sur le plan mathématique : le théorème de Bayes est énoncé et dérivé proprement, les notations (x minuscule pour un scalaire, X majuscule pour un vecteur) sont explicitées, et l’exemple numérique est cohérent de bout en bout. Les calculs de likelihood (6/8), de prior (8/15) et de posterior (0,86) sont exacts. En revanche, l’appareil de sources est inexistant : aucune référence bibliographique, aucun article fondateur cité nommément (Bayes, McCulloch et Pitts, Zadeh, Pawlak ne sont pas nommés explicitement ou seulement par allusion), et la description de la vidéo ne contient aucun lien. Les dates historiques sont approximatives et parfois contradictoires (Bayes tantôt « 16e siècle », tantôt 1763 ; réseaux de neurones « 47 ou 48 » puis 1943 ; rough sets « 1983 ou 86 »), ce qui nuit à la précision sans invalider le fond. L’adéquation titre/contenu est bonne : le titre annonce « différents outils et applications du ML », et la vidéo couvre effectivement un panorama d’outils (approches bayésienne, neuronale, floue, génétique) et une application (classification d’objets par mesure de longueur), même si le terme « applications » reste traité de manière très générale. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
444 mots
Qualité & fiabilité
6/10
Cours universitaire introductif (niveau licence/BTech) présentant les fondements du machine learning : extraction de features, phases d'entraînement et de test, panorama des grandes approches (bayésienne, réseaux de neurones, logique floue, rough sets, algorithmes génétiques, soft computing). Le contenu est exact sur le plan mathématique (théorème de Bayes, posterior/likelihood/prior/evidence, exemple numérique cohérent) et historiquement globalement correct, mais certaines dates sont approximatives ou hésitantes (Bayes « 16e siècle » puis 1763, réseaux de neurones « 47 ou 48 » puis 1943, rough sets « 1983 ou 86 »), et le propos reste très superficiel, sans démonstration formelle complète ni référence bibliographique précise. Aucune source n'est citée dans la description. Fiabilité correcte pour un cours d'introduction, mais sans appareil critique.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Définition de l'extraction de features : réduction d'une image 100×100 à un vecteur compact 1×10.
- Choix du modèle selon le type de problème (classification, clustering, régression) comme étape critique.
- Distinction entre phase d'entraînement et phase de test ; données d'entraînement vs données de test.
- Panorama historique des approches : bayésienne (1763), réseaux de neurones (1943), logique floue (1962), rough sets (années 1980), algorithmes génétiques.
- Définition du soft computing comme combinaison des approches (génétique + flou, neuro-flou, etc.).
- Énoncé du théorème de Bayes : posterior = (likelihood × prior) / evidence, et dérivation depuis la probabilité jointe.
- Exemple numérique : 15 échantillons répartis en 8 (classe 1) et 7 (classe 2), mesures de longueur, construction de la distribution de probabilité.
- Calcul détaillé de la likelihood : probabilité de x=0,1 sachant omega1 (6/8) et sachant omega2 (1/7).
- Calcul du prior (8/15 et 7/15) et de l'evidence par la règle de somme ; décision finale : x=0,1 classé en omega1 avec probabilité 0,86.
- Introduction aux réseaux de neurones : neurone biologique, dendrites, axone, sommation et seuil ; modèle de McCulloch et Pitts (1943).
- Historique des réseaux de neurones : adaptation (1949), réalisation matérielle (1951), blocage attribué à Minsky, périodes fastes des années 1980 et du deep learning.
- Modèle du neurone artificiel : entrées pondérées, sommation, seuil, sortie binaire ; perceptron simple pour deux classes.
- Liste des architectures : perceptron multicouche, mémoires associatives, autoencodeurs, GANs, CNN, RNN, LSTM, GRU.
- Consignes pédagogiques : quiz réguliers en fin de cours, mise à disposition des diapositives.
Apport & nouveautés
Cette vidéo ne présente pas de résultat de recherche original ; il s’agit d’un cours magistral d’introduction qui synthétise des connaissances établies. Son apport réside dans la clarté de la progression pédagogique et dans l’exemple numérique entièrement traité, qui rend concret le théorème de Bayes pour un débutant. Elle situe également les différentes familles d’approches (bayésienne, neuronale, floue, rough sets, génétique) dans une perspective historique et les unifie sous le concept de soft computing, ce qui constitue une grille de lecture utile. En revanche, elle n’apporte aucun élément nouveau pour un public déjà familier du machine learning, et certaines affirmations historiques sont approximatives.
Pour aller plus loin :
- Théorème de Bayes — Fondement mathématique central de la seconde partie du cours.
- Classification naïve bayésienne — Application directe de l’approche bayésienne présentée, avec discussion des hypothèses et limites.
- Réseau de neurones artificiels — Complément sur l’histoire et les architectures évoquées brièvement en fin de cours.
- Logique floue — Approche mentionnée mais non développée, à explorer pour compléter le panorama.
- Soft computing — Concept fédérateur introduit dans la vidéo.
- Algorithme génétique — Approche d’optimisation citée comme inspirée des principes darwiniens.
188 mots
Profil radar
Le profil radar est celui d'un contenu pédagogique introductif : quantité d'information et niveau technique modérés, qualité et fiabilité correctes grâce à l'exactitude mathématique, mais sans profondeur analytique ni appareil de sources. Le contenu est fiable pour un apprentissage de base mais ne constitue pas une référence avancée.