Lecture 19 Perceptron Convergence Part1
Cours 19 Convergence du Perceptron Partie1
Mots-clés
Résumé
233 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
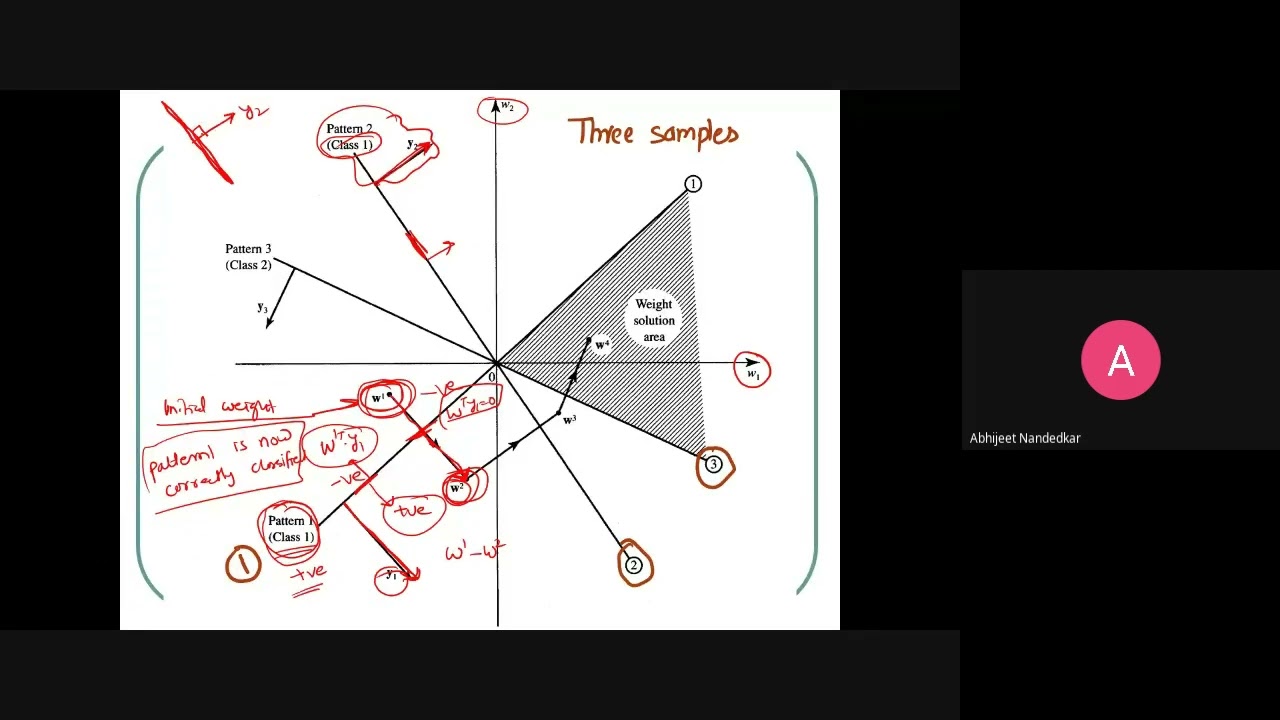
La valeur pédagogique de cette séquence réside dans la construction progressive d’une intuition géométrique solide de la règle d’apprentissage du perceptron. L’enseignant ne se contente pas d’énoncer la formule de mise à jour ; il la dérive à partir de la notion de plus court chemin vers la zone de classification correcte, en identifiant le gradient de W^T y comme direction de déplacement optimale. Cette approche permet de comprendre pourquoi la correction est proportionnelle au vecteur d’entrée et pourquoi le signe dépend de l’erreur commise. L’argumentation est structurée en trois temps : d’abord le cas d’un motif unique, puis un exemple à trois motifs illustrant la réduction progressive de l’espace solution, enfin la généralisation à cinq motifs avec identification de la région de convergence comme intersection de demi-espaces. Le raisonnement est rigoureux dans sa logique géométrique et ne comporte pas de saut conceptuel majeur. La discussion sur le choix du pas C est particulièrement pertinente : elle met en évidence le compromis entre vitesse de convergence et stabilité, un point souvent négligé dans les présentations introductives. L’argumentation reste toutefois informelle sur le plan mathématique : la preuve du théorème de convergence est annoncée mais non fournie, et l’enseignant s’appuie sur des représentations graphiques en 2D sans discuter des limitations en dimensions supérieures. La valeur réside donc dans la clarté de l’exposition et la qualité de l’intuition transmise, plutôt que dans l’apport de résultats nouveaux ou d’une analyse critique approfondie.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique du contenu est satisfaisante pour un cours introductif : les notions présentées (hyperplan séparateur, règle de mise à jour, théorème de convergence) sont des résultats classiques et correctement énoncés. L’enseignant prend soin de distinguer les cas de classification correcte et incorrecte, et la formule ΔW = C·(D − O)·X est présentée comme unifiant l’ensemble des situations, ce qui est exact. Cependant, aucune source bibliographique n’est citée, aucun article fondateur n’est mentionné (ni Rosenblatt, ni Minsky & Papert), et aucune référence à des travaux empiriques n’est fournie. L’enseignant renvoie vaguement à des « livres » et à des « vidéos précédentes » sans les identifier précisément. La démonstration du théorème de convergence, annoncée pour la séance suivante, n’est pas esquissée ici, ce qui laisse le résultat à l’état d’affirmation. L’adéquation entre le titre et le contenu est excellente : la vidéo traite bien de la convergence du perceptron, en première partie, avec l’introduction des concepts nécessaires. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est incluse.
424 mots
Adéquation titre / contenu
Le titre correspond fidèlement au contenu : il s'agit bien de la première partie d'un cours sur la convergence du perceptron, avec introduction de la règle d'apprentissage et du théorème de convergence.
Qualité & fiabilité
7/10
Le contenu repose sur des fondements mathématiques établis (règle d'apprentissage du perceptron, théorème de convergence de Rosenblatt) et l'exposé est cohérent, sans affirmation douteuse. La qualité est toutefois limitée par l'absence de sources explicites, de références bibliographiques et de démonstration formelle (annoncée pour la séance suivante). La présentation graphique en espace des poids est correcte mais reste informelle.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Rappel du fonctionnement du perceptron et de la notion d'hyperplan séparateur dans l'espace des poids.
- Explication du déplacement du vecteur poids par gradient pour atteindre la zone de classification correcte.
- Formulation de la règle de mise à jour : W_nouveau = W_ancien + C·y lorsque la sortie désirée est +1 et la sortie obtenue -1.
- Cas inverse : soustraction du gradient lorsque la sortie désirée est -1 et la sortie obtenue +1.
- Exemple à trois motifs en 2D : présentation séquentielle et réduction progressive de la zone solution.
- Illustration de l'intersection des demi-espaces comme région de convergence pour trois motifs.
- Discussion du rôle du pas d'apprentissage C : compromis entre convergence lente et saut par-dessus la zone solution.
- Exercice proposé avec cinq motifs : recherche de l'aire de convergence par intersection des contraintes.
- Forme générale ΔW = C·(D − O)·X et annulation automatique de la correction en cas de réponse correcte.
- Énoncé du théorème de convergence du perceptron : convergence en un nombre fini d'itérations si les classes sont linéairement séparables.
Apport & nouveautés
Cette vidéo n’apporte pas de résultat nouveau : elle constitue une séance de cours introductive sur la règle d’apprentissage du perceptron et le théorème de convergence. Son originalité réside dans la qualité de la présentation géométrique en espace des poids, qui permet de visualiser concrètement le processus d’apprentissage comme un déplacement du vecteur poids vers l’intersection des demi-espaces définis par chaque motif. L’enseignant insiste sur le rôle du pas d’apprentissage et sur l’unification des cas de correction par la formule ΔW = C·(D − O)·X, ce qui constitue une synthèse pédagogique utile. La démonstration du théorème de convergence est annoncée pour la séance suivante.
Pour aller plus loin :
- Perceptron — Article encyclopédique présentant l’histoire, le modèle et la règle d’apprentissage du perceptron.
- Théorème de convergence du perceptron — Section détaillant l’énoncé et les conditions du théorème de convergence.
- Frank Rosenblatt, « The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain », Psychological Review, 1958 — Article fondateur introduisant le perceptron et sa règle d’apprentissage.
- Marvin Minsky et Seymour Papert, « Perceptrons: An Introduction to Computational Geometry », MIT Press, 1969 — Ouvrage analysant les limites du perceptron simple, notamment l’impossibilité de résoudre le problème XOR.
200 mots
Profil radar
Le profil radar montre un contenu à forte densité informative et à bonne qualité pédagogique, avec un niveau technique modéré correspondant à un cours introductif. La fiabilité est solide sur le plan conceptuel mais pénalisée par l'absence de sources explicites et de démonstration formelle. L'ensemble est équilibré pour une ressource d'apprentissage.