Evan Peters - Generalization despite overfitting in quantum machine learning models
Evan Peters - Généralisation malgré le sur-apprentissage dans les modèles d'apprentissage automatique quantique
Mots-clés
Résumé
113 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
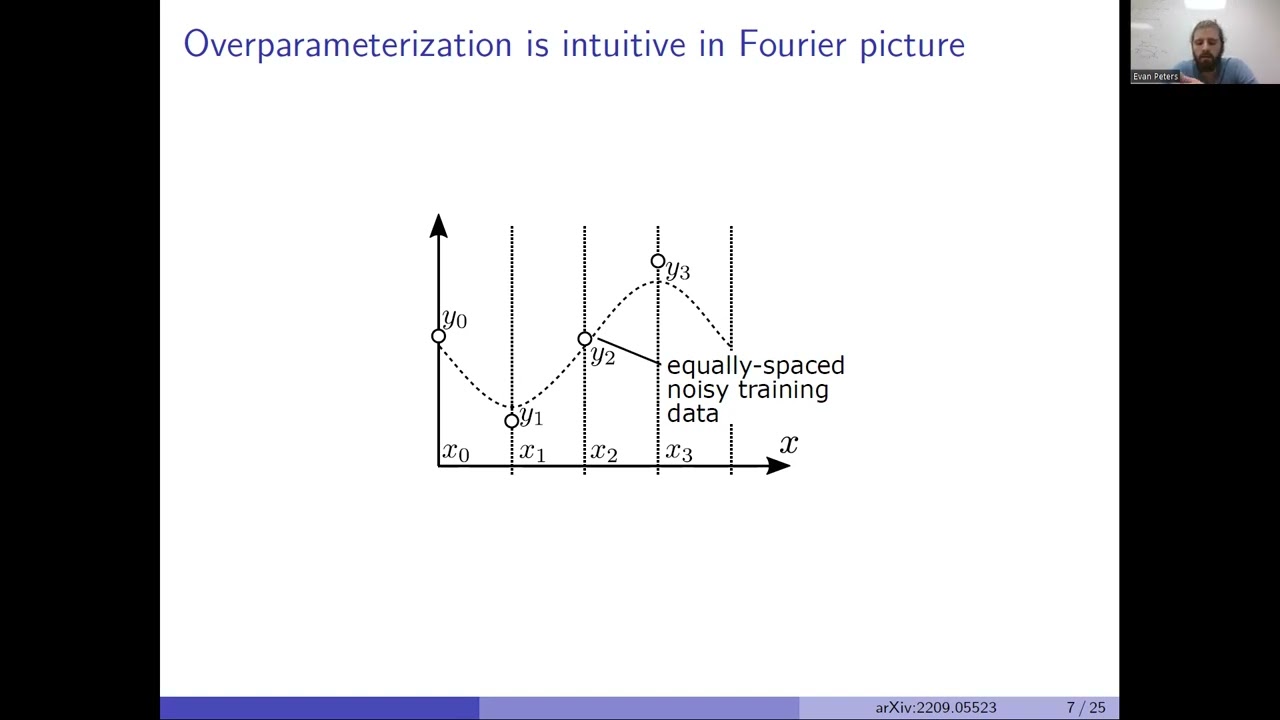
Le travail apporte une caractérisation formelle du sur-apprentissage bénin dans le contexte quantique, un sujet peu étudié. L’argumentation est rigoureuse : l’auteur dérive analytiquement le comportement de modèles classiques et quantiques, et fournit des exemples numériques illustratifs. La comparaison avec le cas classique aide à comprendre le mécanisme, et les explications intuitives (comme le pic local et la queue de fréquence) sont éclairantes.
Rigueur scientifique, qualité des sources, adéquation du titre
La vidéo cite la prépublication arXiv associée, et l’exposé s’appuie sur des résultats antérieurs. Le titre est fidèle au contenu, qui traite précisément de la généralisation malgré le sur-apprentissage dans les modèles quantiques. La présentation est bien structurée, avec des dérivations mathématiques et des schémas pédagogiques. Aucune source externe n’est mentionnée au-delà de l’arXiv, mais le niveau scientifique est élevé.
138 mots
Adéquation titre / contenu
Le titre reflète exactement le contenu : la conférence traite de la généralisation malgré le sur-apprentissage dans les modèles d'apprentissage automatique quantique.
Qualité & fiabilité
8/10
Exposé théorique rigoureux, s'appuyant sur une prépublication arXiv, avec des dérivations détaillées et des exemples illustratifs. La recherche est originale mais non encore publiée dans une revue à comité de lecture, ce qui justifie une note élevée mais pas maximale.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction et plan de l'exposé.
- Sur-apprentissage bénin classique : définition et exemples.
- Représentation de Fourier pour les modèles classiques.
- Expression des modèles quantiques en séries de Fourier.
- Stratégies d'encodage et biais inductif.
- Résultats sur la généralisation dans les modèles quantiques.
Sources citées
- Generalization despite overfitting in quantum machine learning models — Prépublication présentée dans l'exposé, source principale des résultats.
Apport & nouveautés
L’apport original réside dans la démonstration que le sur-apprentissage bénin peut se produire dans les modèles quantiques, en reliant la structure des circuits (encodage des données, état d’entrée) aux poids de Fourier du modèle entraîné. Ce travail ouvre la voie à une meilleure compréhension de la généralisation en apprentissage quantique et à des principes de conception de circuits favorisant une bonne généralisation.
Pour aller plus loin :
- Sur-apprentissage bénin — concept central en apprentissage statistique, défini et discuté dans le contexte classique.
- Apprentissage automatique quantique — domaine général dans lequel s’inscrit cette recherche.
- Analyse de Fourier — outil mathématique utilisé pour représenter les modèles quantiques et classiques.
107 mots
Profil radar
Le profil radar montre une excellente quantité et qualité d'information, un niveau technique très élevé, mais une fiabilité modérée en raison du caractère non publié de la recherche. Cela indique un contenu dense et avancé, adapté à un public averti.