Master Deep Learning in 6 Days: Day 3 - Activation Function, Regression & Classification MLPNN,Keras
Maîtrisez le Deep Learning en 6 jours : Jour 3 - Fonction d'activation, régression et classification MLPNN, Keras
Mots-clés
Résumé
186 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur pédagogique est élevée : les concepts sont expliqués pas à pas avec des schémas mentaux (exemples de détection de bords dans les images, ou d’arrondi dans la régression). L’argumentation est solide, fondée sur les équations mathématiques et les propriétés des fonctions, comme la nécessité d’une dérivée non nulle pour la rétropropagation. La comparaison des dérivées des fonctions d’activation est convaincante, mettant en évidence le problème du vanishing gradient pour la sigmoïde. La démonstration de la non-linéarité nécessaire est claire : sans activation, une pile de couches reste équivalente à une seule régression linéaire. La discussion sur le choix de la fonction de coût (MSE vs MAE) est nuancée, intégrant la robustesse aux outliers. Globalement, l’argumentation est cohérente et ancrée dans les mathématiques du deep learning, bien que certains exemples restent théoriques.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est globalement bonne : le formateur s’appuie sur des fondements mathématiques solides (calcul de dérivées, compositions linéaires) et précise les conditions d’application. Les explications sur l’initialisation aléatoire et la rupture de symétrie sont exactes. Cependant, aucune source n’est mentionnée explicitement, et certains passages utilisent un langage approximatif (tautologies). La description de la vidéo ne contient aucun lien ou référence à des travaux académiques. L’adéquation titre-contenu est parfaite : le contenu correspond précisément au programme annoncé. On note aussi que la vidéo comporte une séquence publicitaire non précisée dans la transcription, mais qui semble intégrée au cours (non détectée ici).
250 mots
Adéquation titre / contenu
Le titre correspond exactement au contenu : il s'agit bien de la troisième journée d'un cours sur le deep learning, consacrée aux fonctions d'activation, à la régression et à la classification avec un perceptron multicouche, en utilisant Keras.
Qualité & fiabilité
7/10
Le contenu est structuré et couvre en profondeur les fondamentaux des réseaux de neurones multicouches : propagation, rétropropagation, fonctions d'activation, choix de la couche de sortie et fonctions de coût. L'explication est pédagogique avec des intuitions géométriques, mais aucune source n'est citée et les exemples numériques restent limités. La fiabilité générale est correcte, mais l'absence de validation expérimentale et de références bibliographiques empêche une note maximale.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Rappel du perceptron simple et de ses limites sur des données non linéairement séparables.
- Explication de la propagation avant et de la rétropropagation, notion de gradient.
- Problème de symétrie des poids et nécessité d'une initialisation aléatoire.
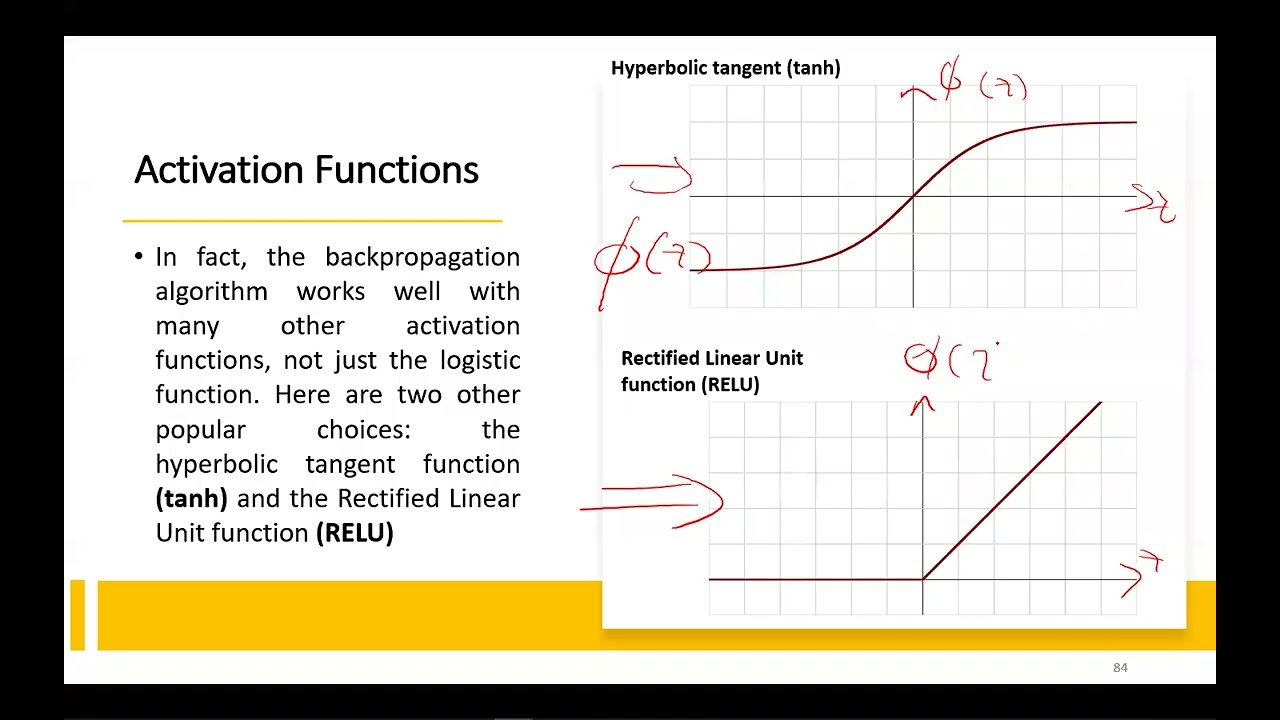
- Comparaison détaillée des fonctions d'activation : step, sigmoïde, tanh, ReLU, et de leurs dérivées.
- Discussion sur le choix de la fonction d'activation dans la couche de sortie (régression vs classification).
- Comparaison des fonctions de coût MSE et MAE, sensibilité aux outliers.
- Conclusion : interprétalité des réseaux de neurones et perspectives (GAN, GPT, deepfakes).
Apport & nouveautés
L’apport original de cette vidéo est son approche pédagogique immersive : elle relie systématiquement les intuitions mathématiques (dérivées, gradients) à des exemples concrets (détection d’objets, prédiction de prix de maison). La distinction entre MSE et MAE est bien contextualisée, et l’explication de la symétrie des poids est rare dans les ressources francophones. Le rappel des architectures modernes (GAN, GPT) en fin de cours motive l’apprentissage.
Pour aller plus loin :
- Fonction d’activation — Wikipédia : synthèse des propriétés des fonctions d’activation courantes et de leur rôle dans les réseaux de neurones.
- Rétropropagation du gradient — Wikipédia : explication détaillée de l’algorithme d’apprentissage.
- Perceptron multicouche — Wikipédia : architecture et formules de base du MLP.
- Keras — Site officiel : documentation de la bibliothèque utilisée dans le cours.
- Fonction de coût (en statistique) — Wikipédia : notions de fonction de perte et de risque empirique.
144 mots
Profil radar
Le profil radar est équilibré, avec une quantité d'information élevée (8/10) et un niveau technique correct (7/10), mais la fiabilité globale est moindre (6/10) en raison de l'absence de sources et de la précision variable. La qualité est légèrement inférieure à la quantité, reflétant un contenu dense mais peu étayé.