Apprentissage par la machine
Thema UYQM

L8 Feature Scaling, Regularization Ridge, Lasso, ElasticNET, and Early Stopping
L8 Mise à l'échelle des caractéristiques, Régularisation Ridge, Lasso, ElasticNET et Arrêt précoce
★
★
★
★
☆
4/5

Hal Daume: Domain Adaptation in Natural Language Processing
Hal Daumé : Adaptation au domaine en traitement automatique du langage naturel
★
★
★
★
☆
4/5

Daphne Koller: Probabilistic Models of Relational Domains
Daphne Koller: Modèles probabilistes de domaines relationnels
★
★
★
★
★
5/5


Ventajas de IBM Small Models, AI motores y caballos, Cuestionando la cross-entropy
Avantages des petits modèles IBM, IA moteurs et chevaux, Remettre en question la cross-entropie
★
★
★
☆
☆
3/5
Kilian Weinberger: Learning with Marginalized Corrupted Features
Kilian Weinberger: Apprentissage avec des caractéristiques corrompues marginalisées
★
★
★
★
☆
4/5

Targeted Unlearning with Single Layer Unlearning Gradient
Désapprentissage ciblé avec gradient de désapprentissage à couche unique
★
★
★
☆
☆
3/5
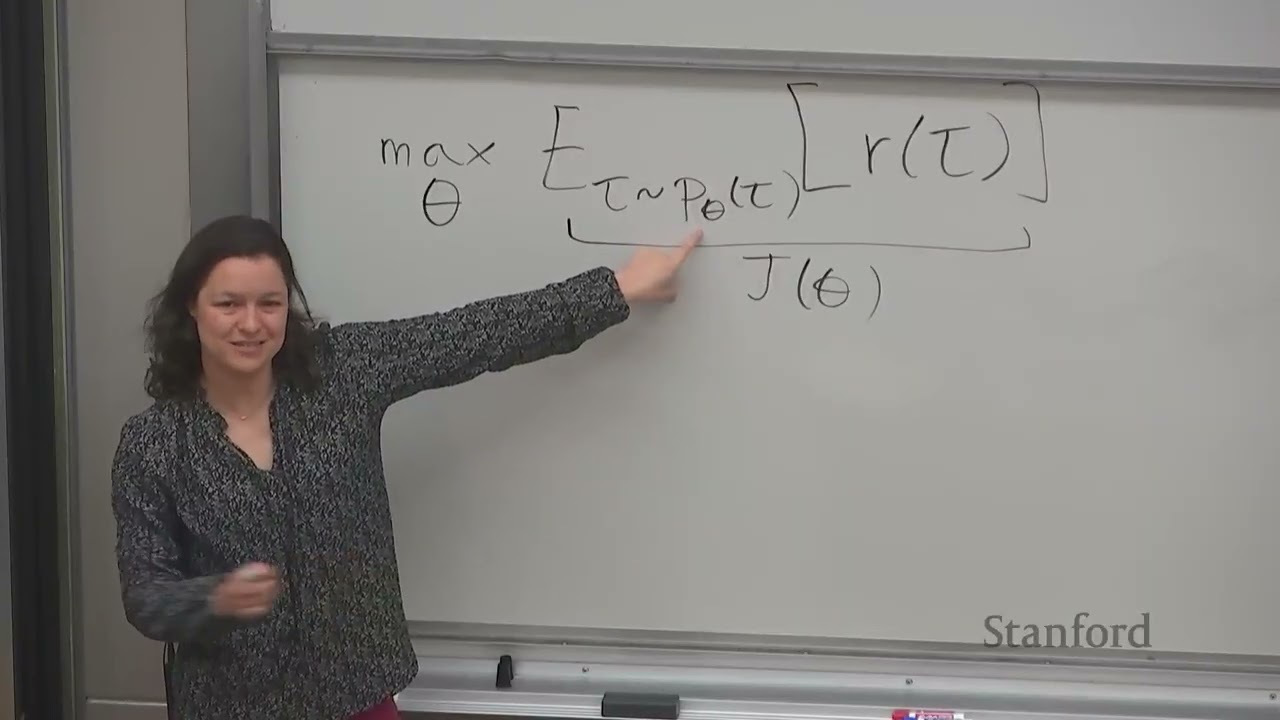
Stanford CS224R Deep Reinforcement Learning | Spring 2025 | Lecture 3: Policy Gradients
Stanford CS224R Apprentissage par renforcement profond | Printemps 2025 | Cours 3 : Gradients de politique
★
★
★
★
★
5/5

Stanford CS224R Deep Reinforcement Learning | Spring 2025 | Lecture 2: Imitation Learning
Stanford CS224R Apprentissage par Renforcement Profond | Printemps 2025 | Conférence 2 : Apprentissage par Imitation
★
★
★
★
★
5/5

Stanford CS224R Deep Reinforcement Learning | Spring 2025 | Lecture 16: RL for Robots
Stanford CS224R Apprentissage par Renforcement Profond | Printemps 2025 | Cours 16 : Apprentissage par Renforcement pour les Robots
★
★
★
★
★
5/5

Stanford CS224R Deep Reinforcement Learning | Spring 2025 | Lecture 1: Class Intro
Stanford CS224R Apprentissage par renforcement profond | Printemps 2025 | Cours 1 : Introduction
★
★
★
★
★
5/5
On the Impossibility of Retrain Equivalence in Machine Unlearning
Sur l'impossibilité de l'équivalence de réentraînement dans le désapprentissage machine
★
★
★
★
☆
4/5
Tensor Logic "Unifies" AI Paradigms [Pedro Domingos]
La logique tensorielle « unifie » les paradigmes de l'IA [Pedro Domingos]
★
★
★
★
☆
4/5

Automatise ton projet avec Nano Banana Pro et N8N !
★
★
★
★
☆
4/5


[ИАД, осень 2025] Вероятностные тематические модели. Лекция 12
[ИАД, automne 2025] Modèles thématiques probabilistes. Conférence 12
★
★
★
★
☆
4/5

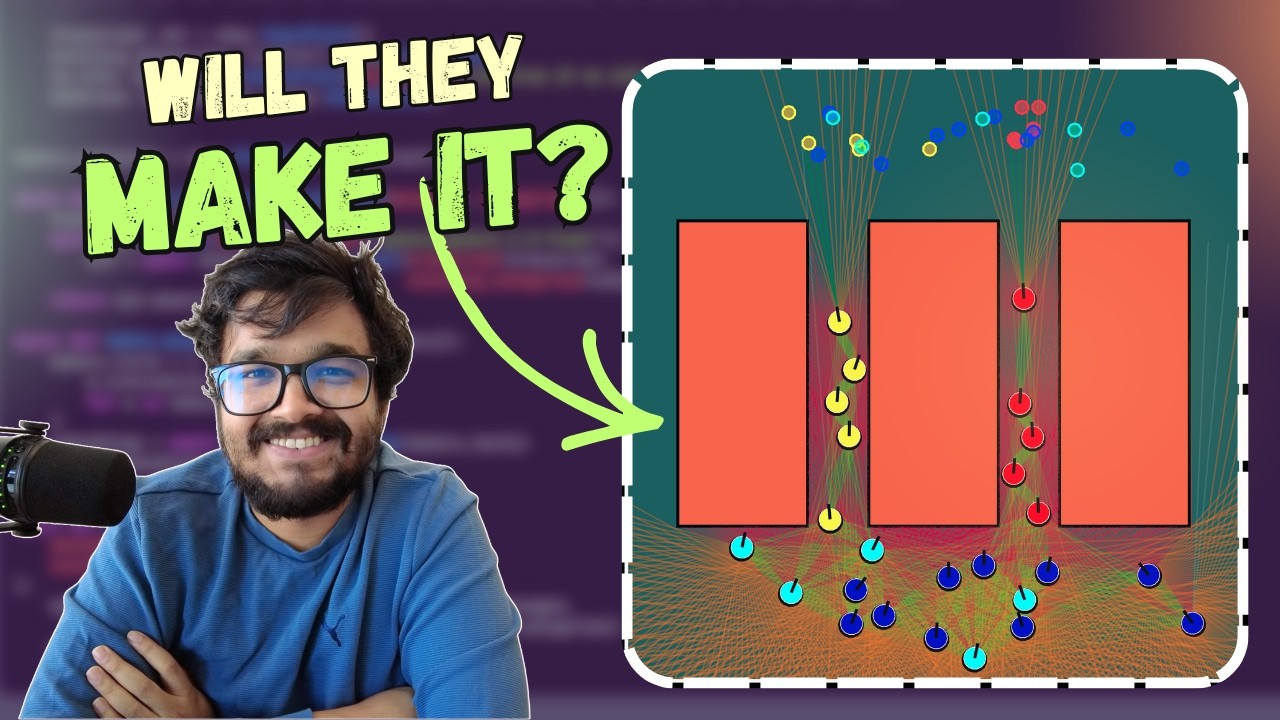
How to train Multi Agent Collaborative Agents with Reinforcement Learning (CTDE Explained)
Comment entraîner des agents collaboratifs multi-agents avec l'apprentissage par renforcement (CTDE expliqué)
★
★
★
★
☆
4/5

[ИАД, осень 2025] Вероятностные тематические модели. Лекция 11
[ИАД, automne 2025] Modèles thématiques probabilistes. Cours 11
★
★
★
★
☆
4/5

[ИАД, осень 2025] Foundational models for spatial-time series. Занятие 8
[IAD, automne 2025] Modèles fondateurs pour séries temporelles spatiales. Cours 8
★
★
★
★
☆
4/5

OpenAI Just Leveled Up n8n AI Agents (here's how it works)
OpenAI vient de faire passer ses agents d'IA n8n au niveau supérieur (voici comment ça fonctionne)
★
★
★
★
☆
4/5

Understanding Tiny Hierarchical Reasoning Models
Comprendre les modèles de raisonnement hiérarchique miniatures
★
★
★
★
☆
4/5
ML Basics Study Group Week 5 & 6 Meeting
Groupe d'étude des bases du ML Réunion des semaines 5 et 6
★
★
☆
☆
☆
2/5




[ИАД, осень 2025] Математические методы прогнозирования. Лекция 8
[ИАД, осень 2025] Méthodes mathématiques de prévision. Conférence 8
★
★
★
★
☆
4/5

The Thinking Game | Full documentary | Tribeca Film Festival official selection
The Thinking Game | Documentaire complet | Sélection officielle du Festival du film de Tribeca
★
★
★
★
★
5/5

Gemini's New File Search Just Leveled Up RAG Agents (10x Cheaper)
La nouvelle recherche de fichiers de Gemini vient de faire passer les agents RAG au niveau supérieur (10x moins cher)
★
★
★
★
☆
4/5

Trustworthy Machine Learning for Astrophysical Discovery
Apprentissage automatique fiable pour la découverte astrophysique
★
★
★
★
☆
4/5

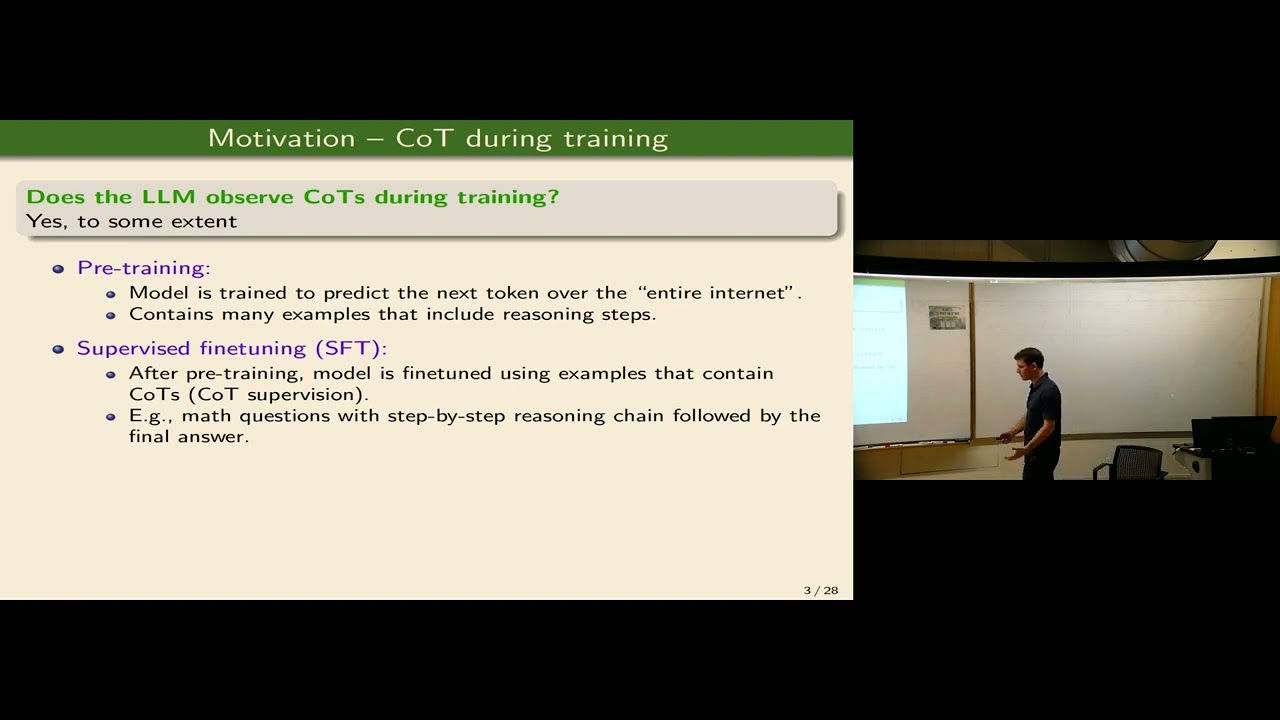
Gal Vardi - A Theory of Learning with Autoregressive Chain of Thought (Heb)
Gal Vardi - Une théorie de l'apprentissage avec chaîne de pensée autorégressive (Heb)
★
★
★
★
☆
4/5
